
学習プロセス
入力データがどう前処理され、どう分けられ、どのアルゴリズムで学習されたかを追う画面です。 精度の数字が納得できないときに、どこで何が起きたかをここで確かめます。
全体プロセス
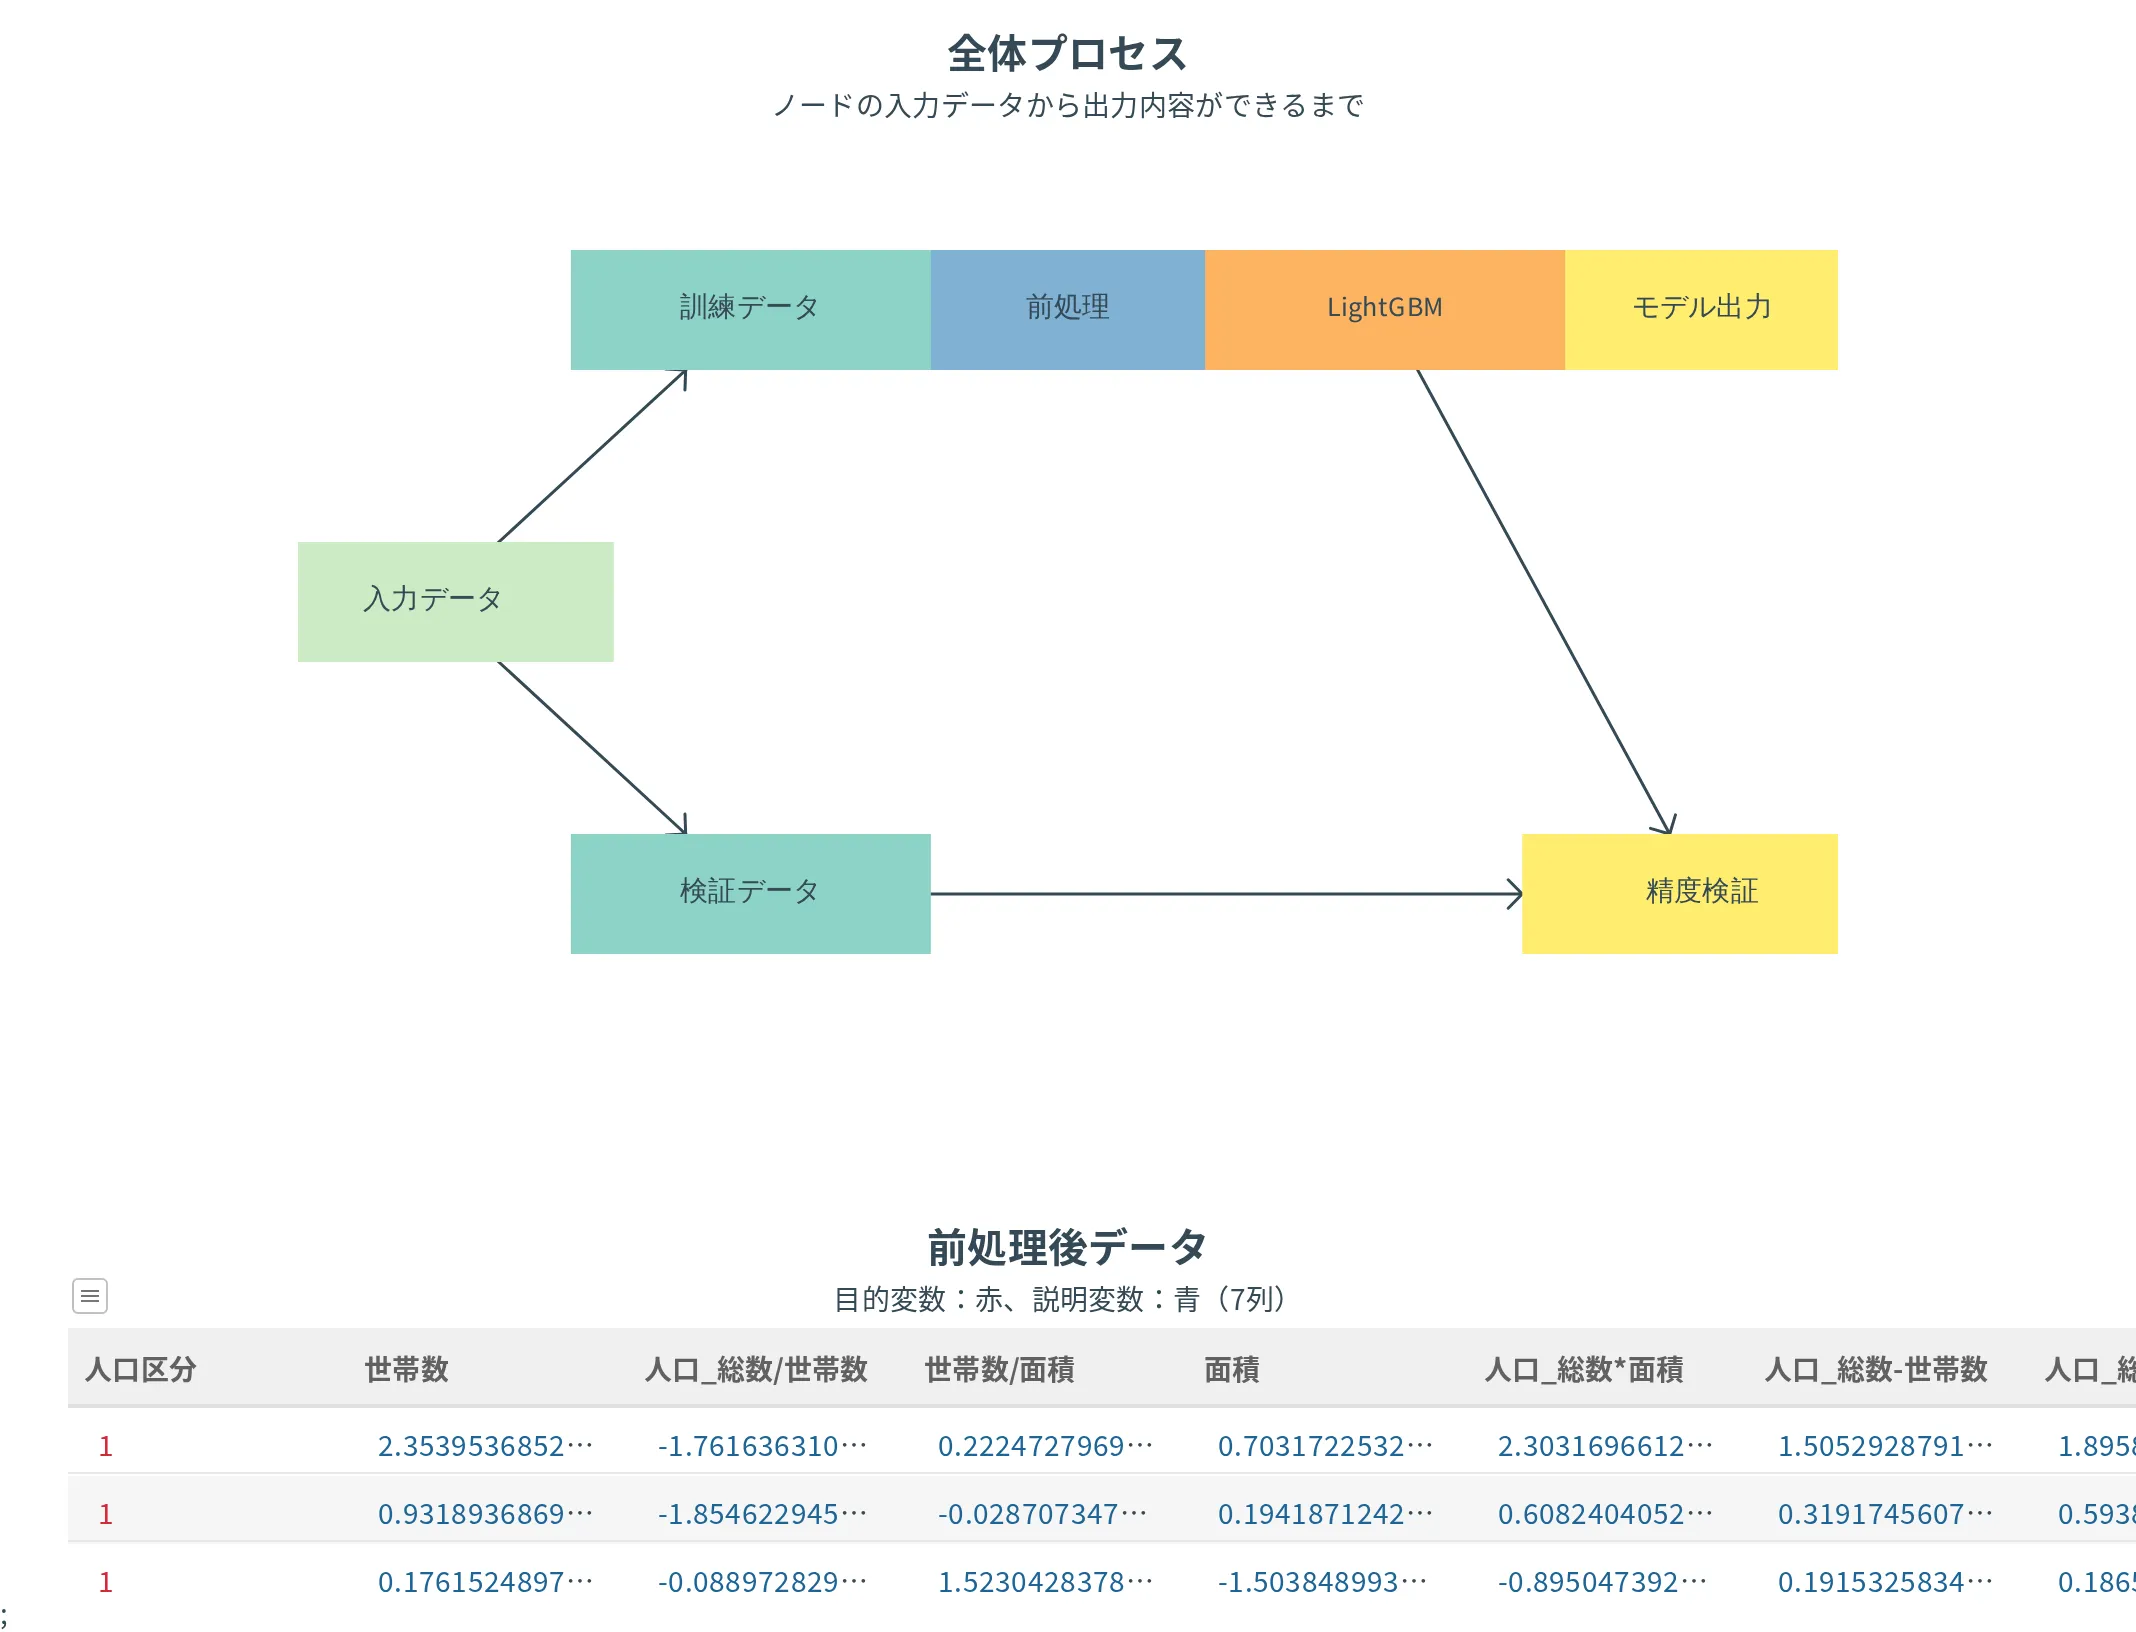
ノードの入力データから出力内容ができるまでを、箱と矢印でたどれます。 読み取れるのは次の 3 つです。
- 入力データが訓練データと検証データにどう分かれたか(箱にマウスを乗せると、割合と行数が出ます)
- 前処理が入ったかどうか
- 最終的に採用された学習アルゴリズム
MLアンサンブル(βver)で作ったモデルでは、アンサンブルの箱が出て、どのアルゴリズムが混ざったかが分かります。
前処理後データ
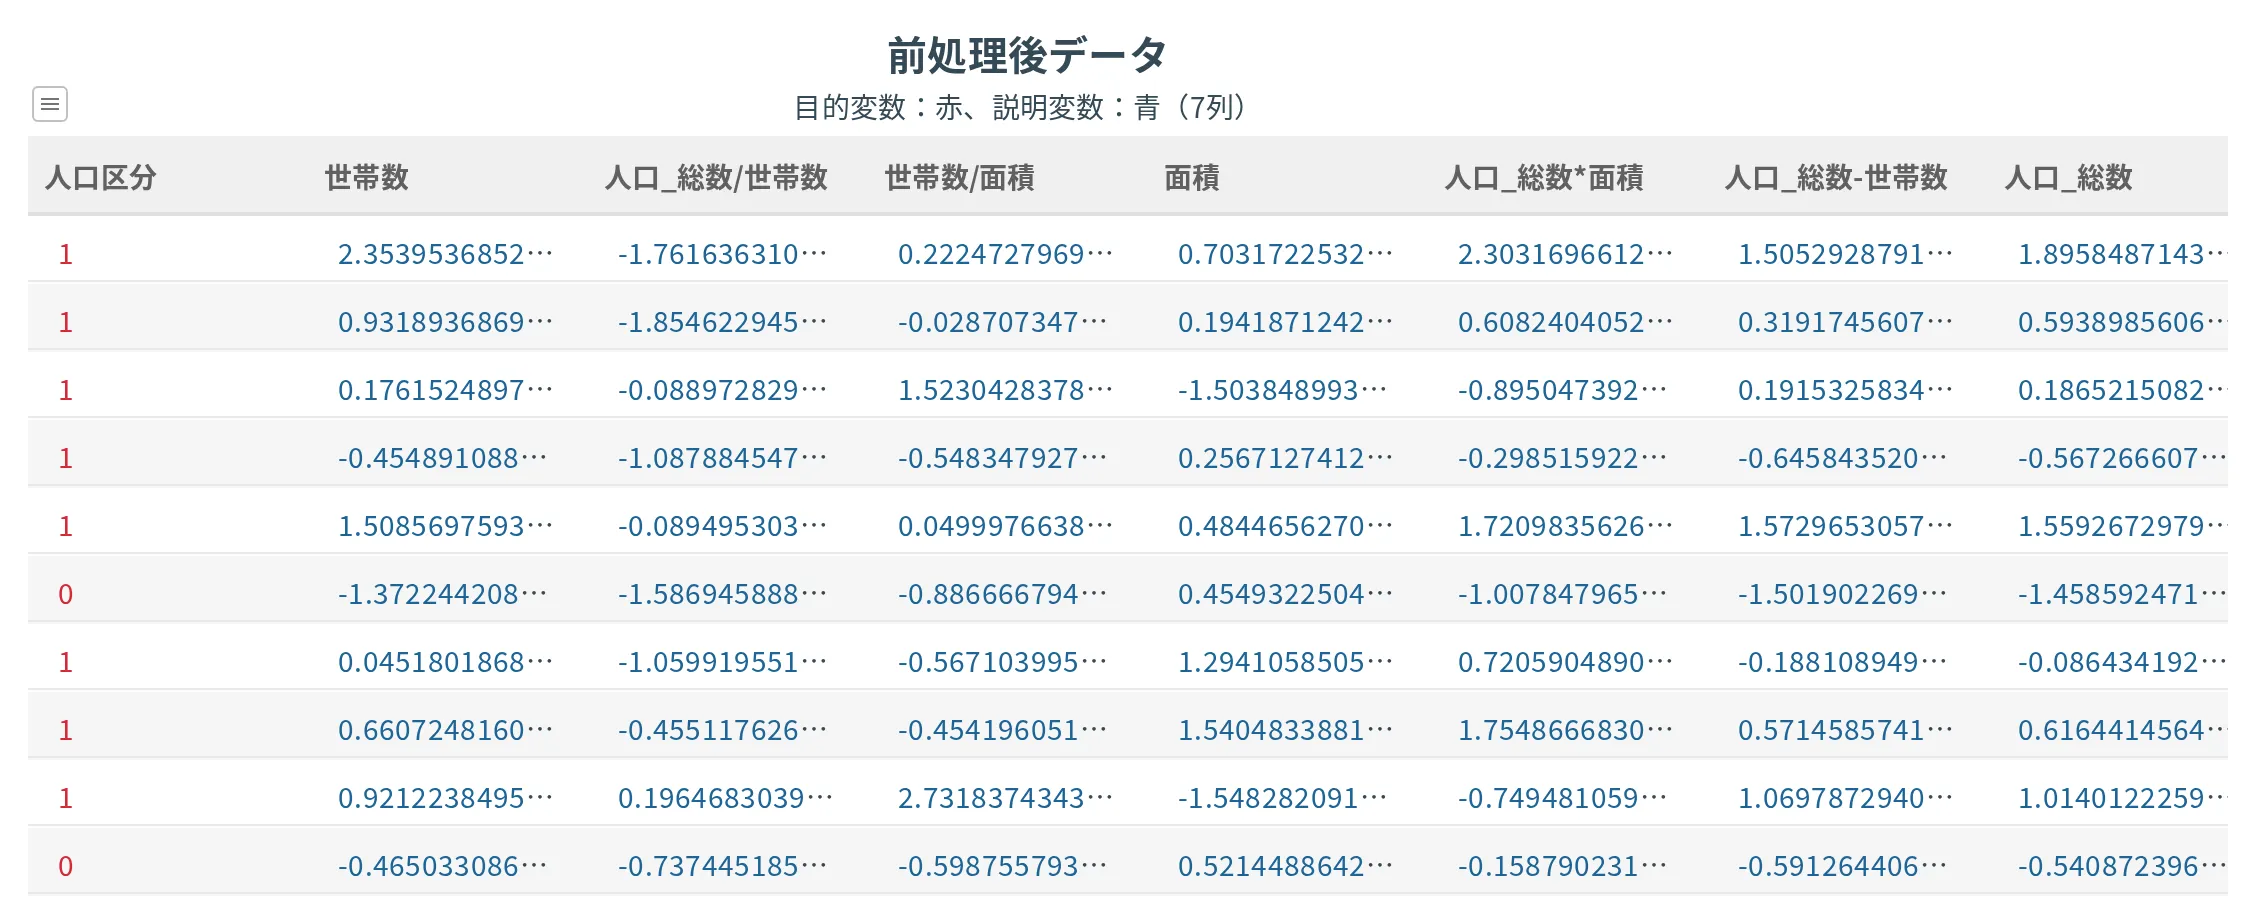
前処理を通したあとのデータの、先頭 10 行です。目的変数の列が赤、説明変数の列が青で塗られます。
前処理で自動的に作られた列も、ここに入っています。 元のデータにない列名が並んでいたら、それは前処理が作ったものです。
前処理プロセス
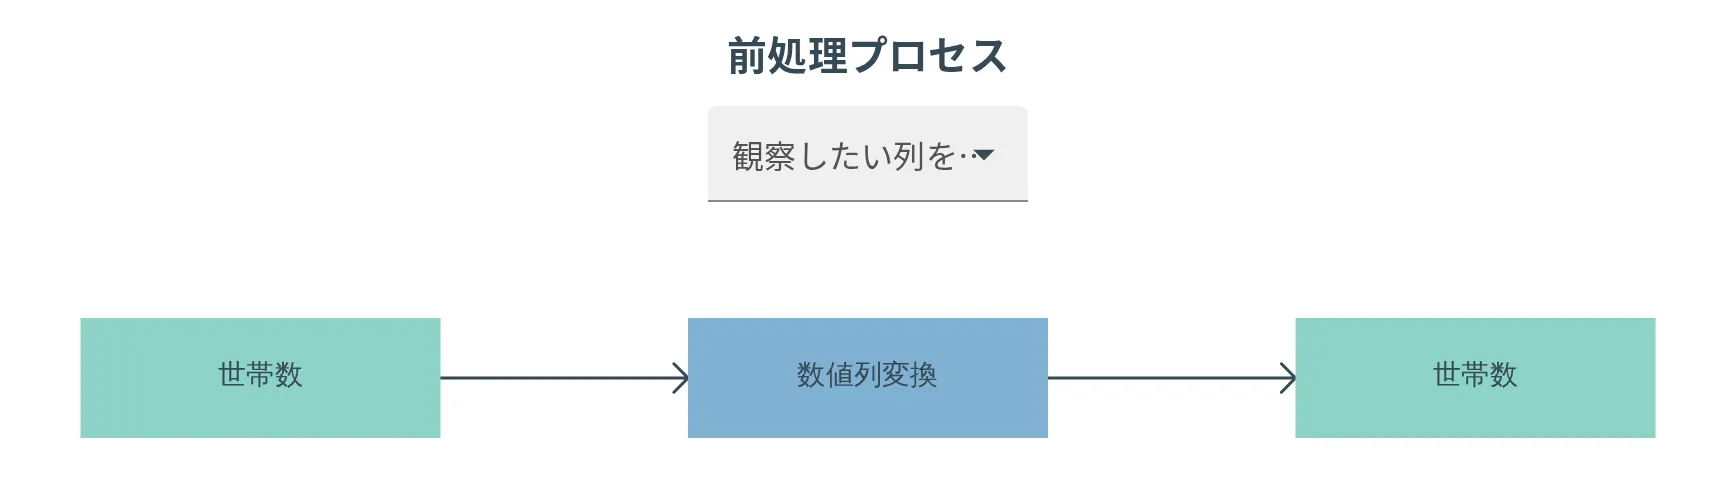
プルダウンで列を 1 つ選ぶと、その列がどう加工されたかが順に図示されます。 箱にマウスを乗せると、どの方法を使ったかなどの細かい情報が出ます。
機械学習パラメータ
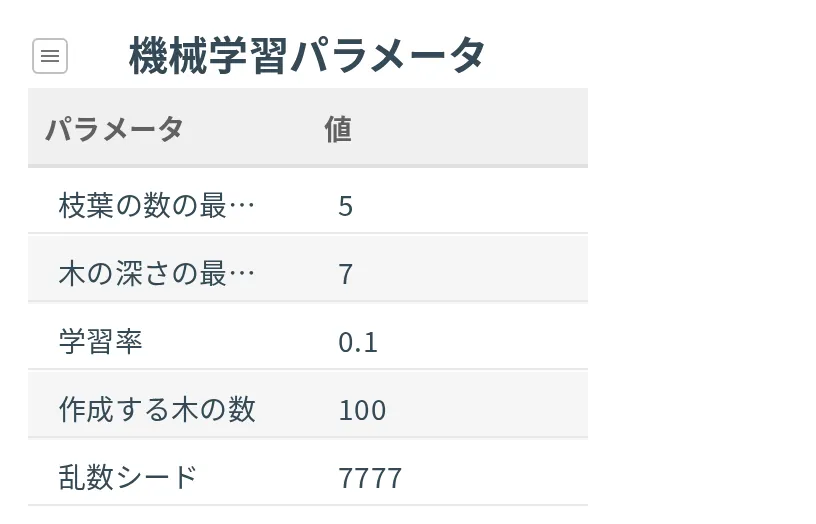
採用されたアルゴリズムの内部のパラメータが、パラメータと値の 2 列で並びます。
MLアンサンブル(βver)のときはモデルIDとアルゴリズムの列も付き、混ぜたモデルの分だけ行が増えます。
決定木グラフ
学習アルゴリズムに決定木が選ばれたときだけ出ます。 木の形で分岐の条件が見えるので、ルールとして読み取れます。
ノードによって出ないもの
| ノード | 出ない節 |
|---|---|
| MLアンサンブル(βver) | 前処理後データ / 前処理プロセス |
| 決定木以外のアルゴリズムが選ばれたとき | 決定木グラフ |
MLアンサンブル(βver)で前処理の節が出ないのは、混ぜた 1 本ずつで前処理の中身が違い、1 枚の図にまとまらないためです。1 本ずつの前処理はモデル詳細情報で見られます。
関連
精度検証結果 同じまとまりのほか
機械が重視したデータ 同じまとまりのほか
モデル詳細情報 候補になったモデルを全部見る
オートML 分け方を変える
モデルで予測値算出 別のデータに当てる
ボニートくんへのアクセス ボニートくんの開き方