
精度検証結果
作ったモデルが使いものになるかを、いちばん先に確かめる画面です。 選んだ指標の値だけでなく、何もしないで予測した場合と比べてどうかまで判定します。
精度のゲージ
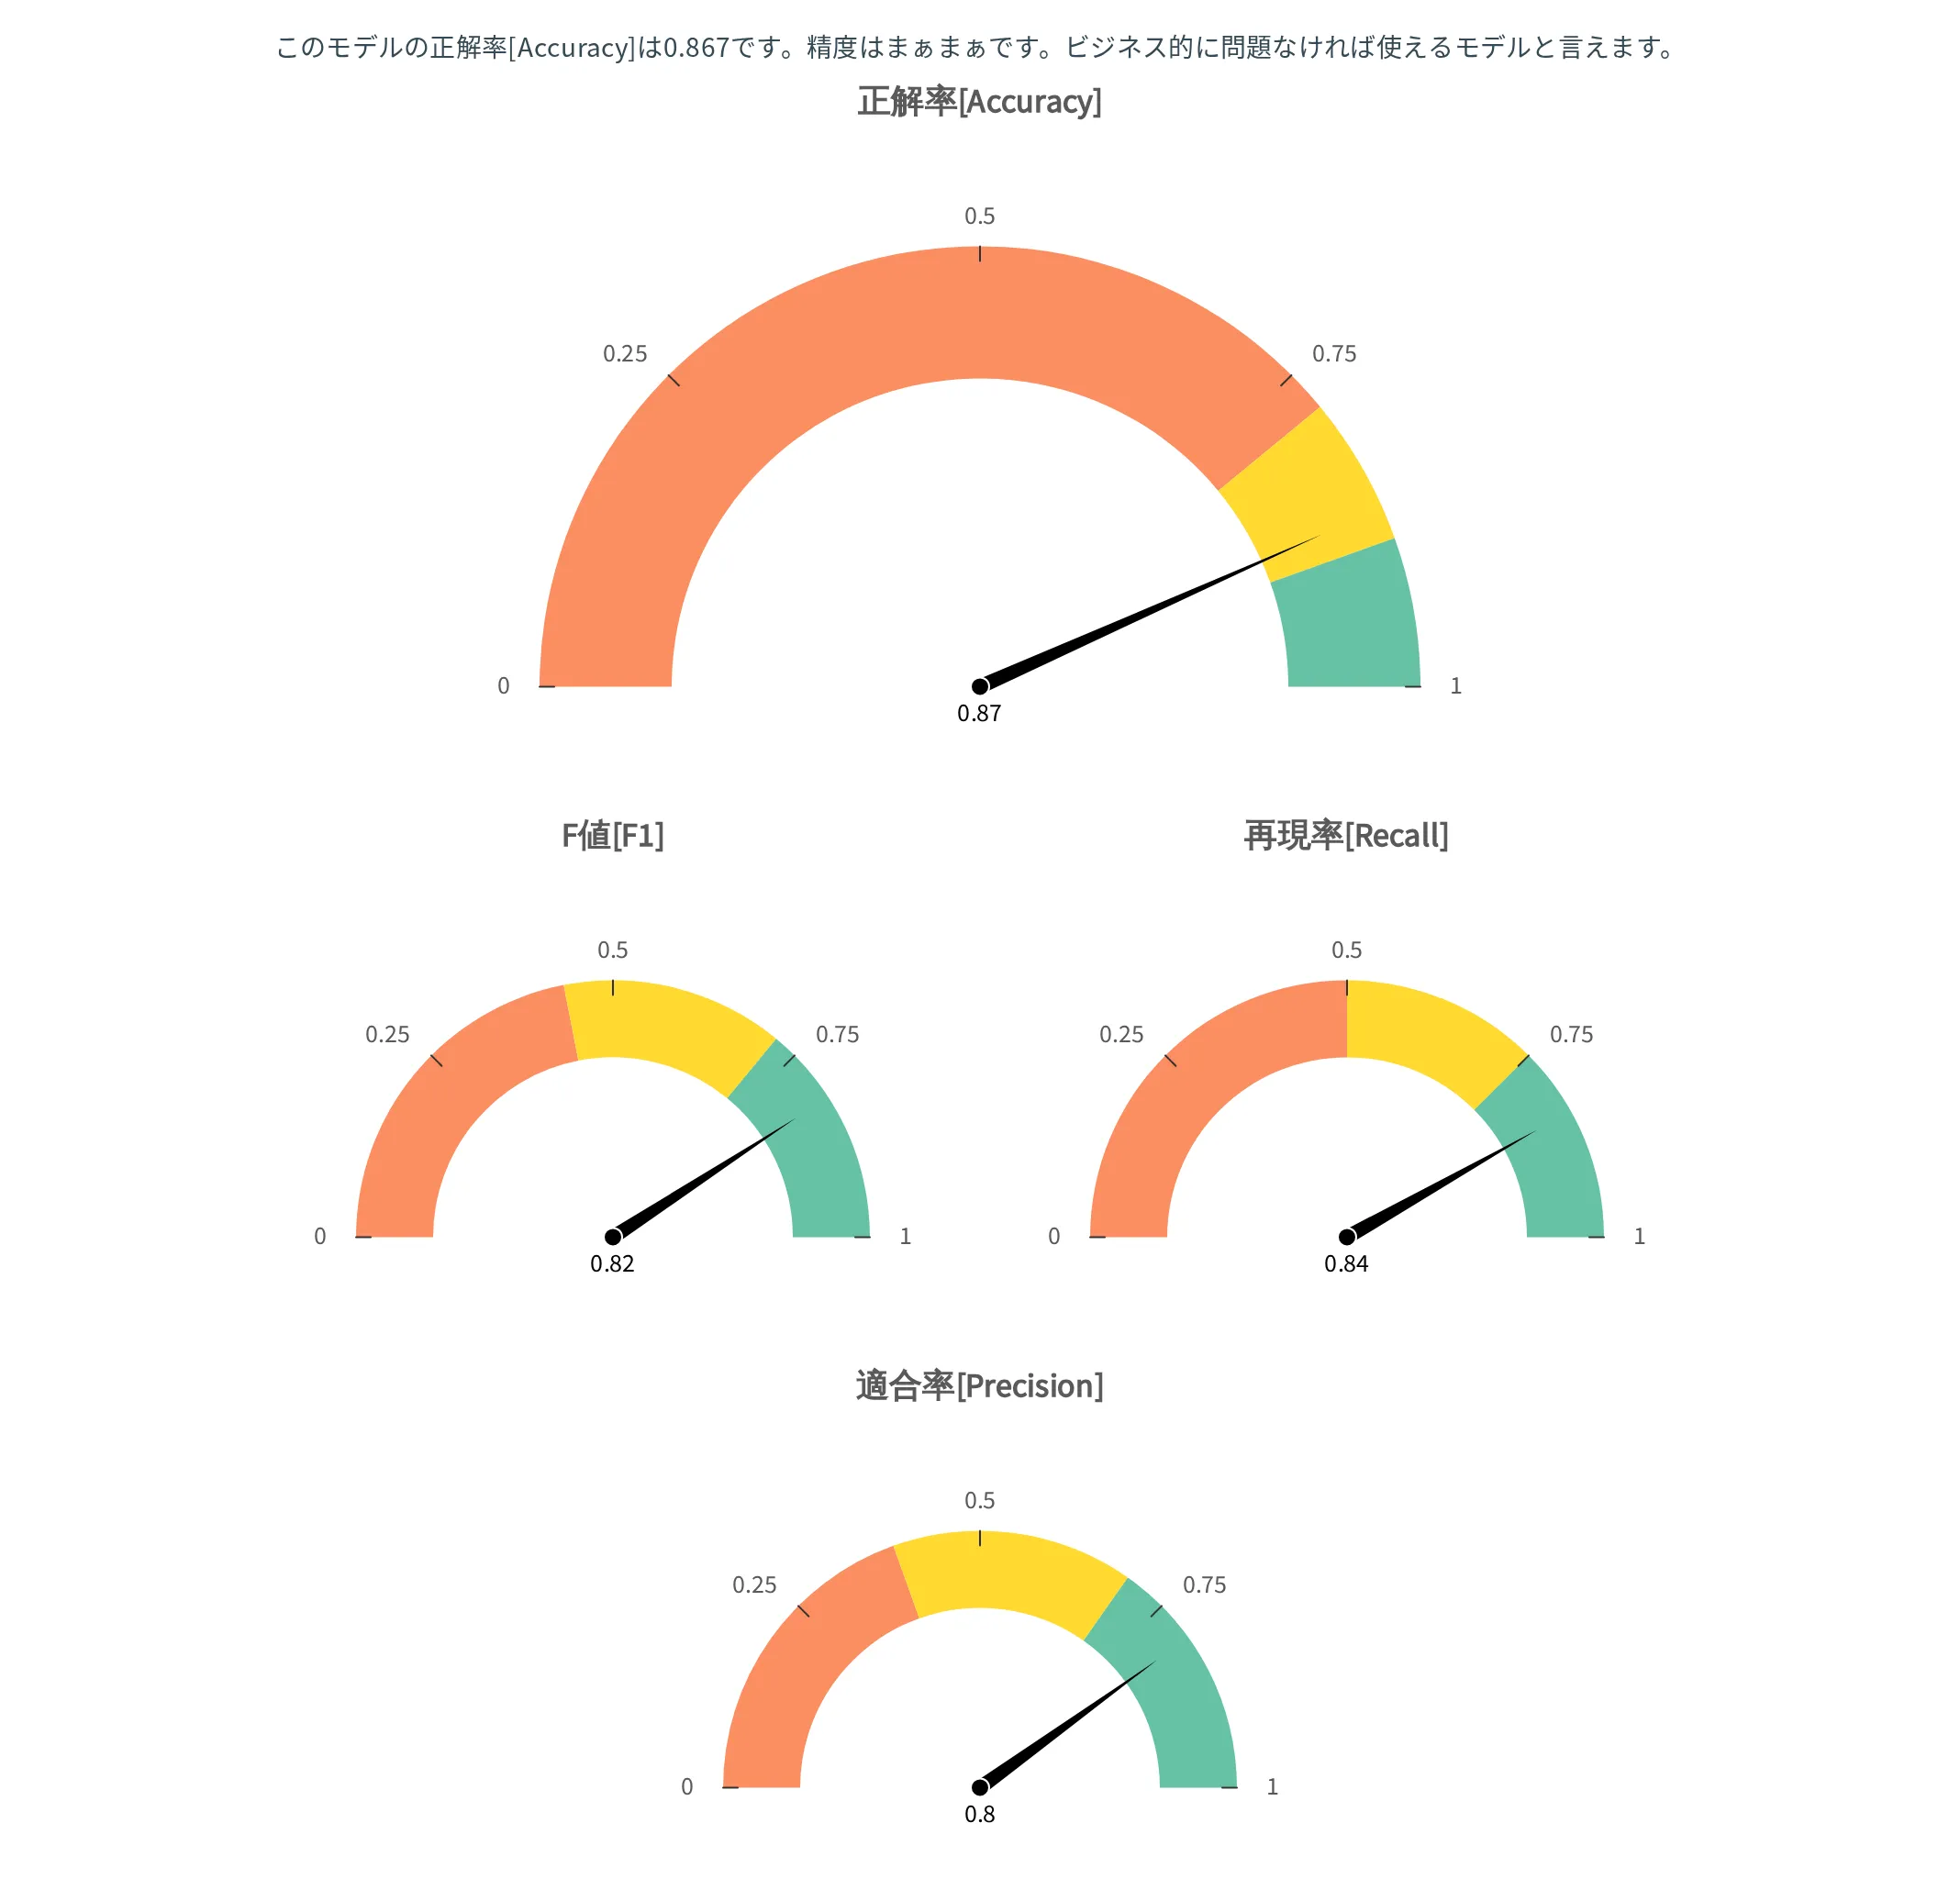
ゲージの上に、選んだ指標の値と判定が 1 文で出ます。
| 判定 | 出る文 |
|---|---|
| 緑 | Great!高い精度が出ております。 |
| 黄 | 精度はまぁまぁです。ビジネス的に問題なければ使えるモデルと言えます。 |
| 橙 | 精度が低く、残念ながら適当に予測した場合と変わりません。 |
色の境目はデータで変わる
境目は「何も考えずに予測したときの成績」を基準に決まります。 同じ 80% でも、データによって緑になることも橙になることもあります。
カテゴリ予測のとき
基準は、全部を同じカテゴリと予測したときの正解率です。
| 色 | 範囲 |
|---|---|
| 橙 | 基準を下回る |
| 黄 | 基準以上、基準と 100% の真ん中まで |
| 緑 | 基準と 100% の真ん中より上 |
たとえば目的変数が生存 90 行・死亡 10 行なら、全部を生存と予測するだけで 90% 当たります。このとき 90% 未満は橙、95% 以上が緑です。
数値予測のとき
基準は、全部を目的変数の平均値と予測したときの誤差です。誤差は小さいほど良いので、色の並びはカテゴリ予測と逆になります。
| 色 | 範囲 |
|---|---|
| 緑 | 基準の半分より小さい誤差 |
| 黄 | 基準の半分以上、基準未満 |
| 橙 | 基準以上の誤差 |
ゲージの目盛りは 0 から基準の 2 倍までです。たとえば平均値で予測したときの誤差が 10% なら、5% 未満が緑、5% 以上 10% 未満が黄、10% 以上が橙になります。
過学習リスク
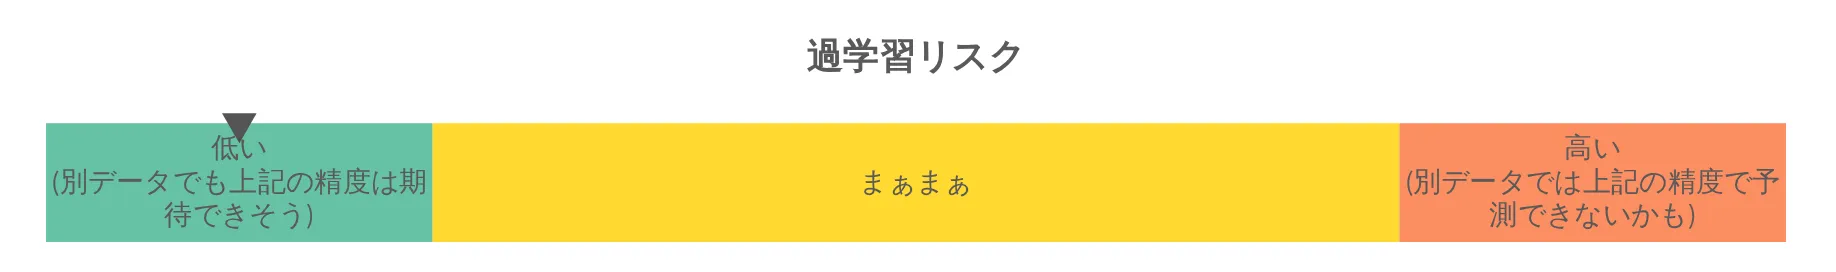
過学習とは、モデルが学習用データの細かい癖まで覚えてしまった状態です。こうなると、別のデータでは同じ精度が出ません。
リスクは 1 から 10 の整数で出ます。訓練用データでの成績と検証用データでの成績がどれだけ離れているかで決まり、離れているほど大きくなります。
| 値 | 判定 |
|---|---|
| 1 〜 3 | 低い(別データでも上記の精度は期待できそう) |
| 3 〜 8 | まぁまぁ |
| 8 〜 10 | 高い(別データでは上記の精度で予測できないかも) |
8 以上になると、ゲージの上に「なお、過学習リスクが高く、別データでは上記の精度で予測できない可能性があります。」と出ます。
数字の決まり方
訓練用データでの成績と検証用データでの成績のずれの割合を段階に当てはめた値です。カテゴリ分類と数値予測でものさしが違います。
| ずれの割合 | カテゴリ分類 | 数値予測 |
|---|---|---|
| 1% まで | 1 | 1 |
| 3% まで | 2 | 1 |
| 5% まで | 3 | 1 |
| 10% まで | 4 | 1 |
| 20% まで | 5 | 2 |
| 30% まで | 6 | 3 |
| 40% まで | 7 | 4 |
| 50% まで | 8 | 5 |
| 60% まで | 9 | 6 |
| 70% まで | 10 | 7 |
| 80% まで | 10 | 8 |
| 90% まで | 10 | 9 |
| それ以上 | 10 | 10 |
同じずれでもカテゴリ分類のほうが大きい値が出ます。 正解率が訓練 0.95 / 検証 0.90 ならずれは約 5% でリスク 3、訓練 0.95 / 検証 0.80 ならずれは約 16% でリスク 5 です。
下げるには
| 原因 | 打ち手 |
|---|---|
| 学習に使ったデータが少ない | 行を増やすか、オートMLの処理モードをカスタムにして「学習に使うデータの行数比率」を上げる |
| パラメータを探しすぎている | 処理モードを速度重視に下げて、探索回数を減らす |
混合行列
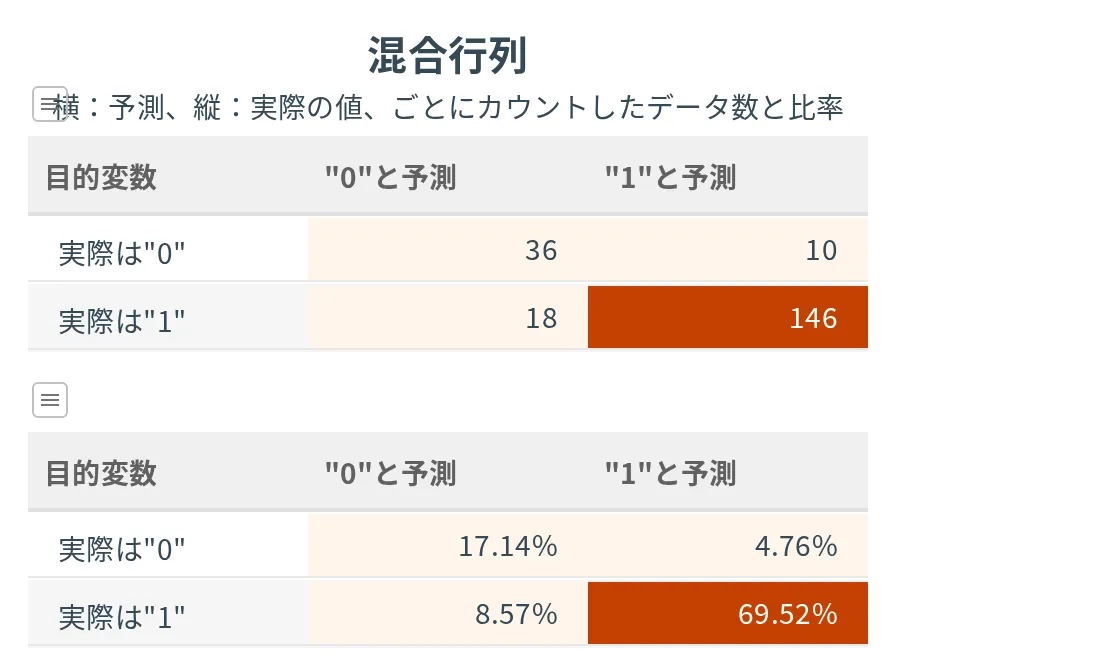
予測と実際の値の組み合わせごとに、データの数と割合を並べた表です。 横が予測、縦が実際の値です。数の表と割合の表が上下に並び、色の濃さで多いところが分かります。
どこで外しているかが見えるので、次に何を直すかの手がかりになります。
数値予測のときは、目的変数を値の小さい順に並べ、データの数が同じになるように 5 つの範囲に分けます。 同じ値が多いと 5 つ未満になることもあります。
精度分解
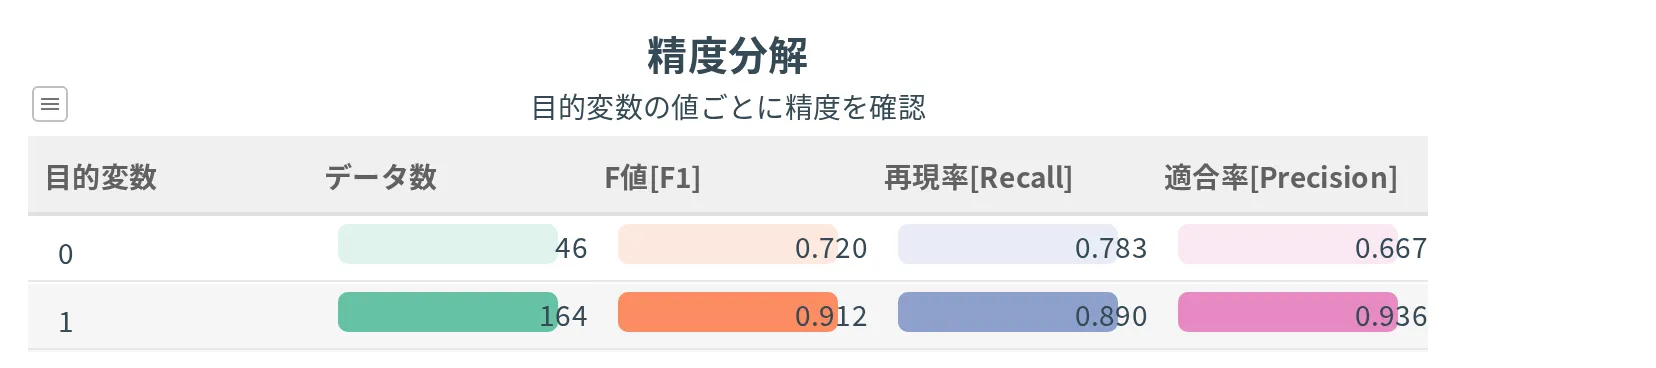
目的変数の値ごとに精度を比べます。 全体では当たっていても、特定のカテゴリだけ当たっていないことが見つかります。
| 予測モード | 1 行の単位 | 並ぶ指標 |
|---|---|---|
| カテゴリ予測 | カテゴリ 1 つ | データ数 / F値[F1] / 再現率[Recall] / 適合率[Precision] |
| 数値予測 | 混合行列と同じ 5 つの範囲 | データ数 / 平均絶対誤差[MAE] / 二乗平均平方根誤差[RMSE] / 平均絶対相対誤差[MAPE] |
学習曲線
ブースティング系のアルゴリズムが選ばれたときだけ出ます。 学習を進めるにつれて、訓練データでの精度と検証データでの精度がどう動いたかの折れ線です。
右へ行くほど 2 本が離れていくなら、過学習が進んでいます。 上の過学習リスクと合わせて見てください。
指標の意味と式
カテゴリ予測の指標
予測と実際の値の組み合わせを ① 〜 ④ として説明します。
| 目的変数 | 1と予測 | 0と予測 |
|---|---|---|
| 実際は1 | ① | ② |
| 実際は0 | ③ | ④ |
- 正解率[Accuracy]
- 予測がどれだけ正解したか。
(① + ④) / (① + ② + ③ + ④) - 再現率[Recall]
- 実際に正であったもののうち、どれだけ正と予測できたか。
① / (① + ②) - 適合率[Precision]
- 正と予測したものが、どれだけ正しかったか。
① / (① + ③) - F値[F1]
- 再現率と適合率を均等に評価した値。
2 * Recall * Precision / (Recall + Precision)
数値予測の指標
- 平均絶対相対誤差[MAPE]
- 予測が実測に対して何 % くらいはずれるか。行ごとに
|予測値 - 実測値| / 実測値を出して平均した値です。 - 平均絶対誤差[MAE]
- 予測が実測に対してどのくらいはずれるか。行ごとに
|予測値 - 実測値|を出して平均した値です。 - 二乗平均平方根誤差[RMSE]
- 行ごとに
(予測値 - 実測値)^2を出して平均し、平方根を取った値です。大きく外した行があるほど値が大きくなるので、誤差を厳しく評価できます。
ノードによって出ないもの
予測精度を評価から開いたときは、過学習リスクと学習曲線が出ません。 このノードはモデルを作らないので、訓練データでの成績も学習の途中経過も持っていないためです。