
精度改善の余地
どの列のせいで予測が外れているのかを並べる画面です。 機械が重視したデータと見た目はそっくりですが、測っているものが違います。あちらは「何で判断したか」、こちらは「何で間違えたか」です。
原因比較
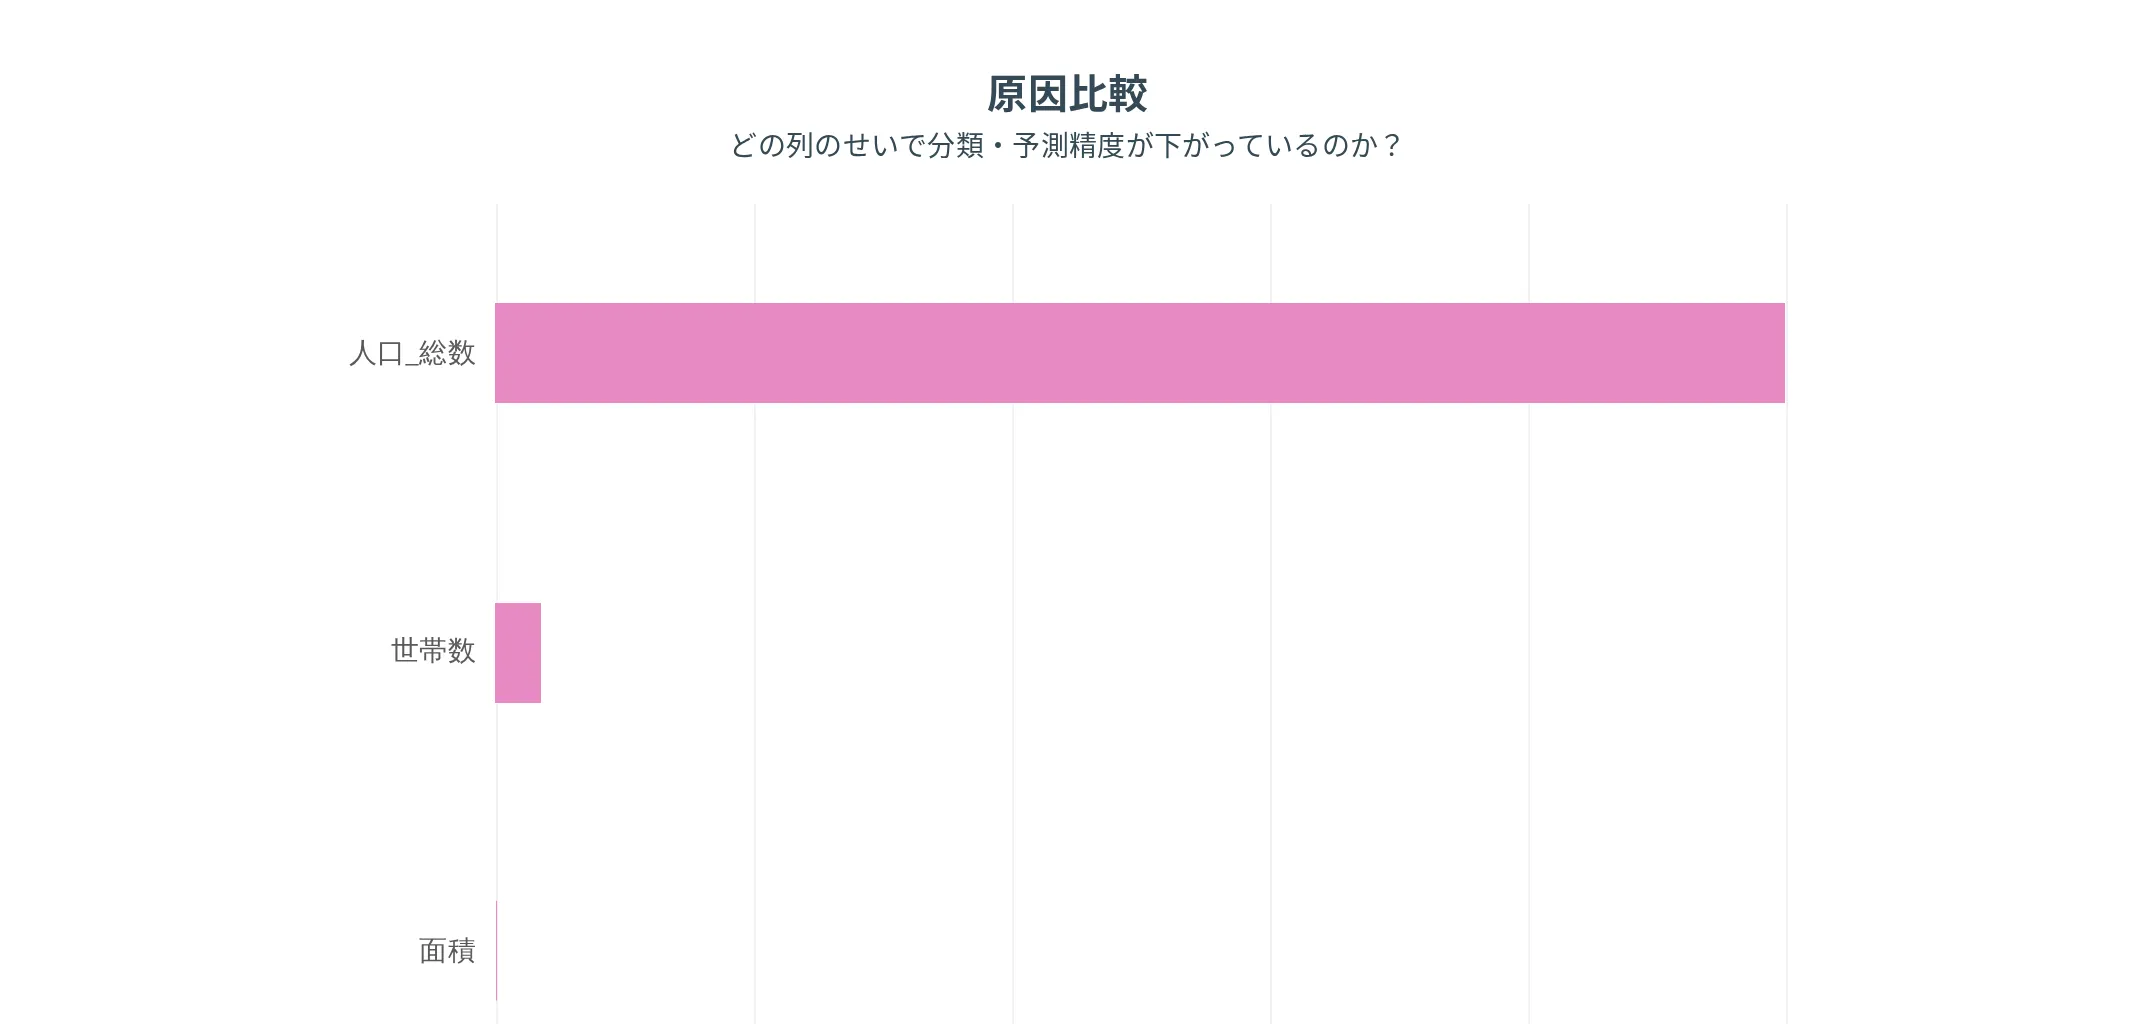
どの列のせいで分類・予測精度が下がっているのか、を順に並べます。 上にある列ほど、精度を落とす要因として大きい列です。
棒の長さはいちばん大きい列を 100 とした相対値で、桃色で描かれます。
列ごとの範囲分解
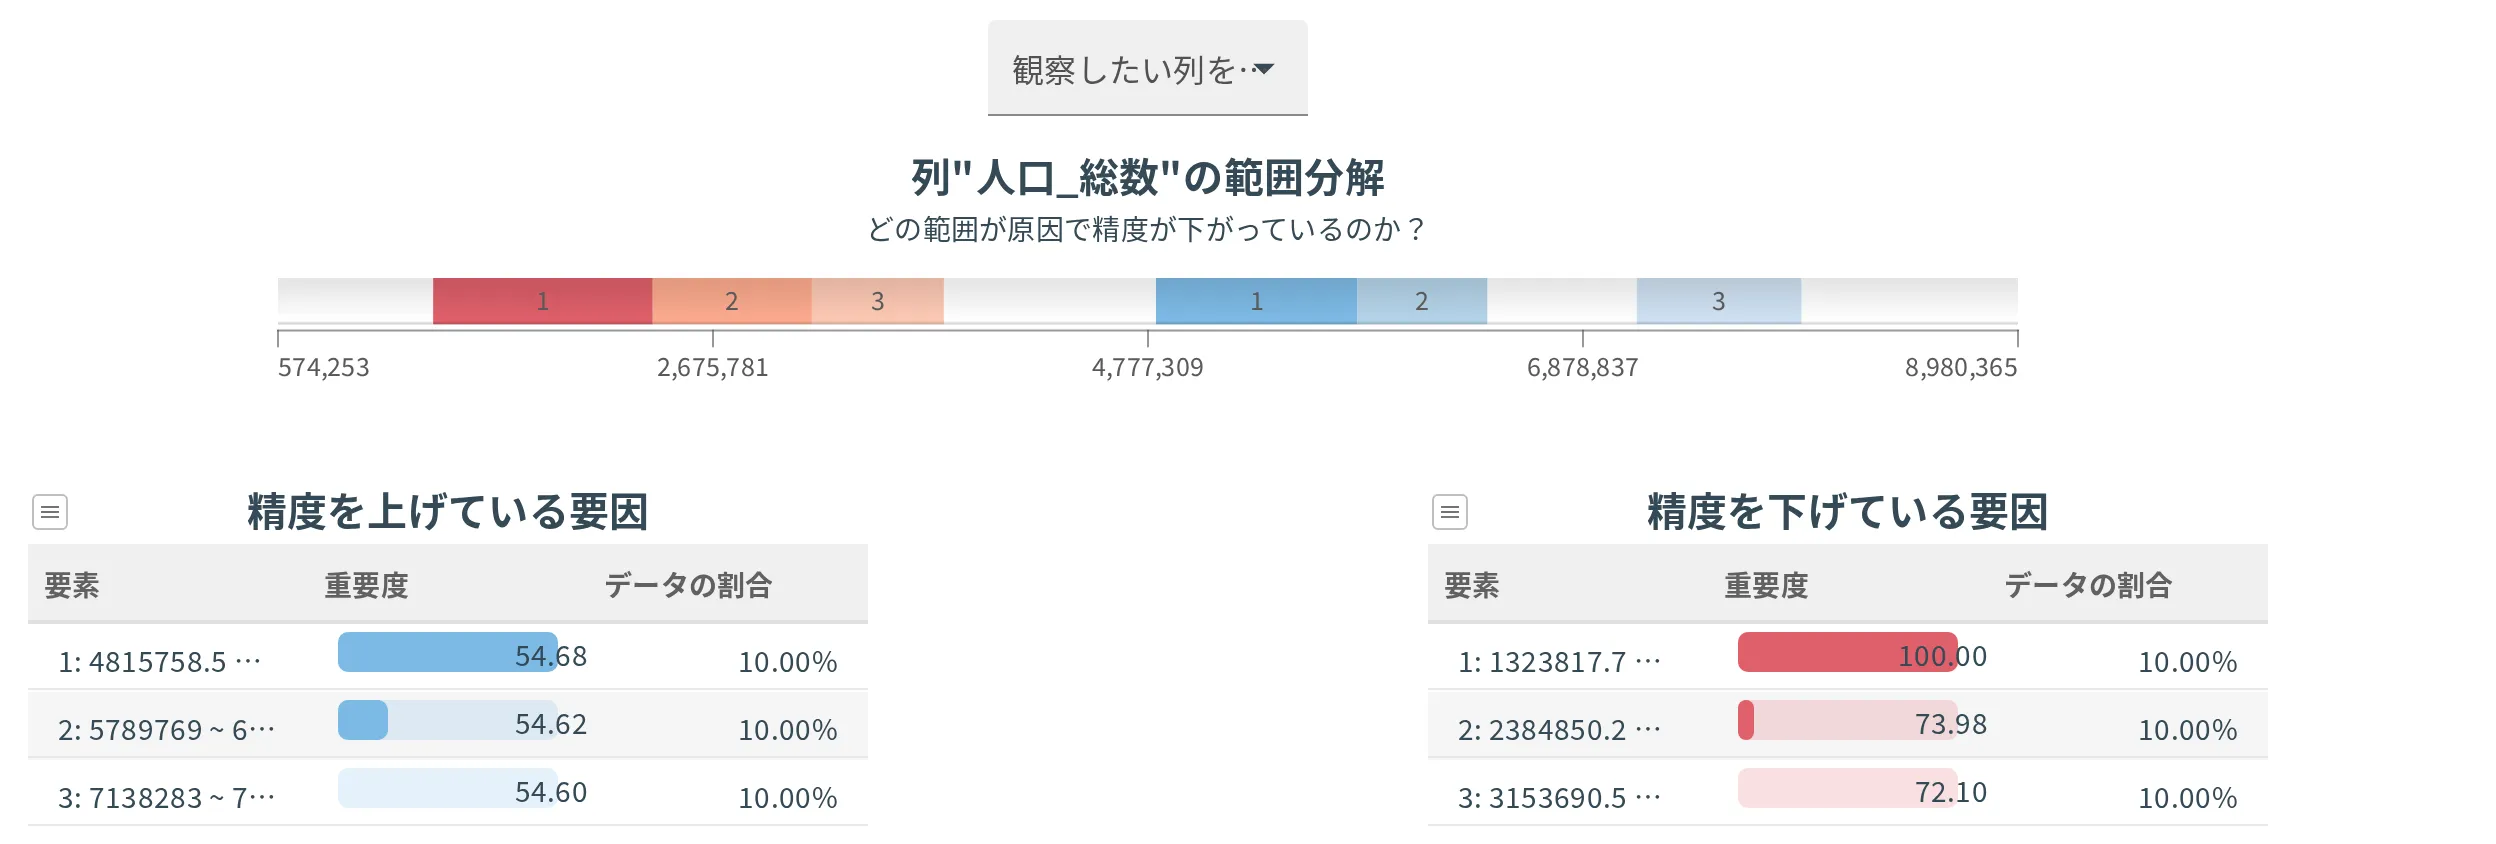
プルダウンで列を 1 つ選ぶと、その列のどの値・どの範囲が足を引っ張っているかが出ます。
| 選んだ列の型 | 分け方 |
|---|---|
| 文字列 | 値ごと |
| 数値 | 件数が同じになるように 10 の範囲に分けます。同じ値が多くて 10 に分けられないときは 5 の範囲 |
見出しは 2 つに分かれます。
| 見出し | 意味 |
|---|---|
| 精度を下げている要因 | その値・範囲の行で、よく外している |
| 精度を上げている要因 | その値・範囲の行は、よく当たっている |
どちらも効きの強い上から 3 つずつが並びます。
範囲ごとの混合行列
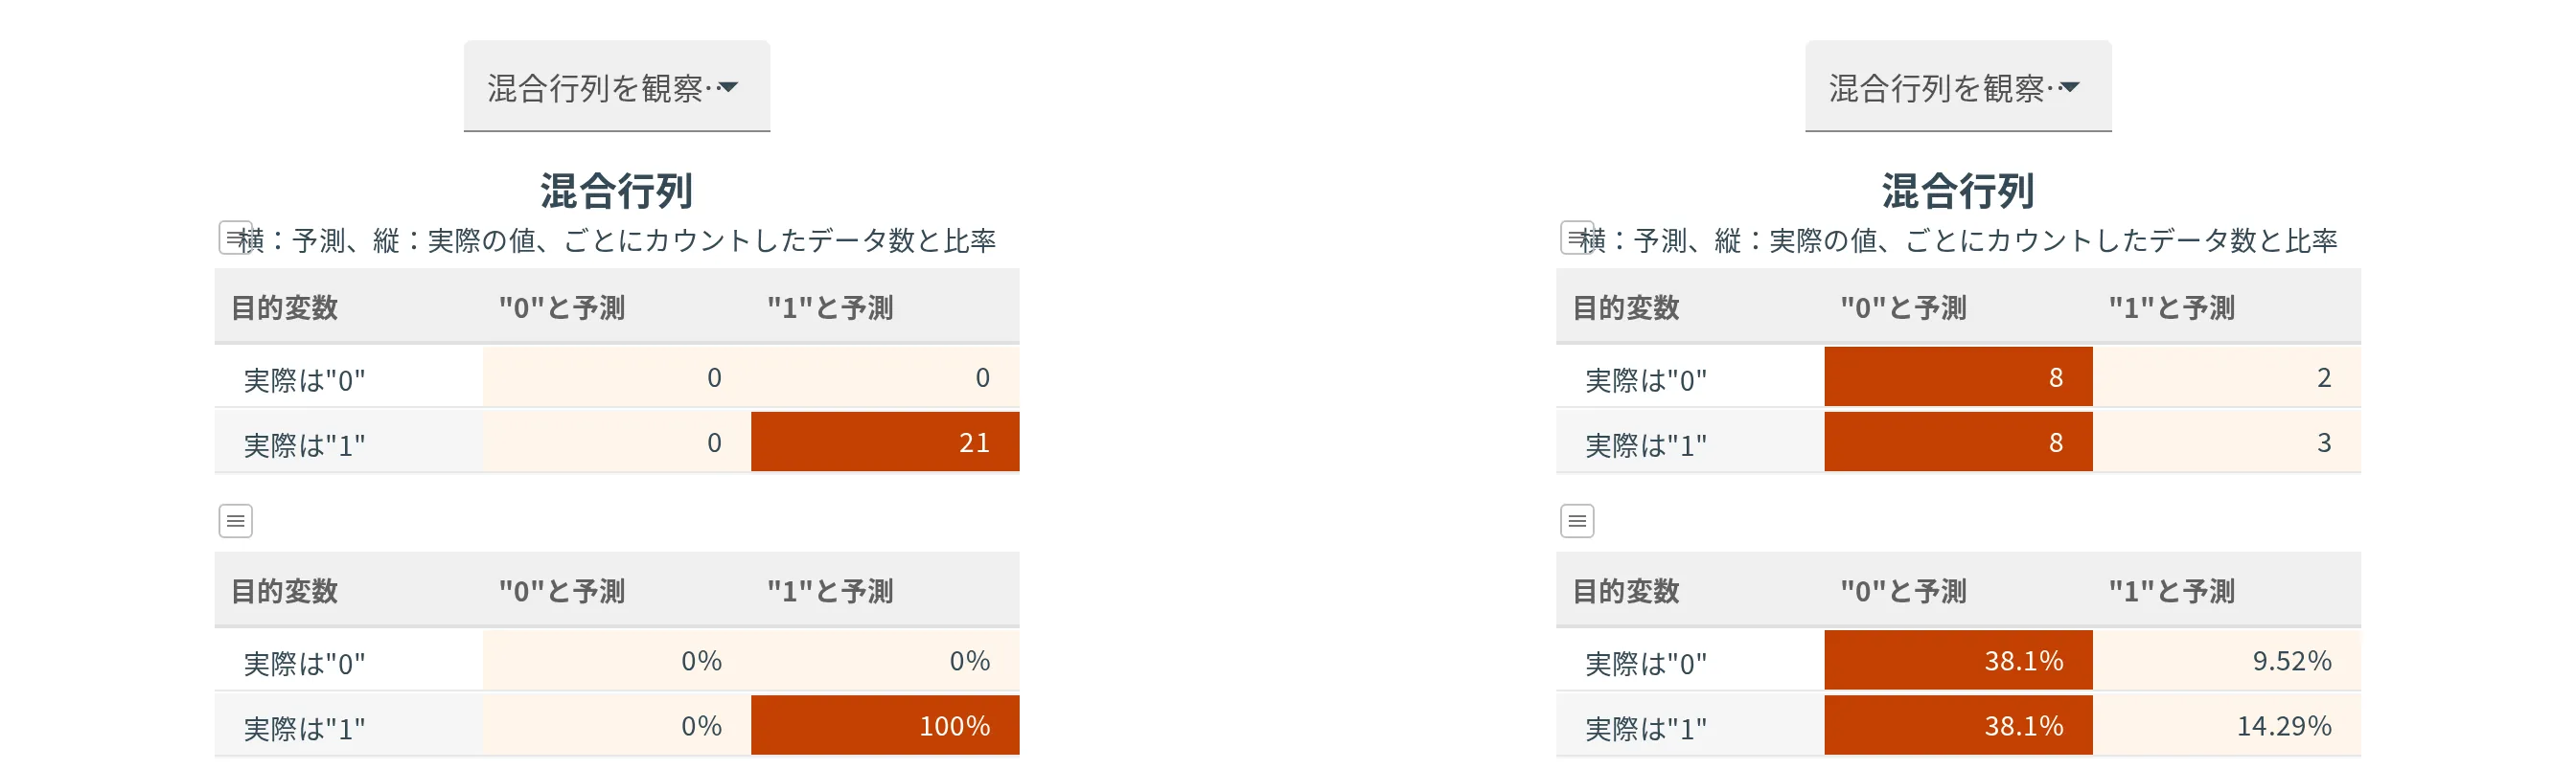
もう 1 つのプルダウンで値や範囲を選ぶと、その行だけを集めた混合行列が出ます。 横が予測、縦が実際の値で、データの数と割合が出ます。どう間違えているのか(取りこぼしているのか、空振りしているのか)がここで分かります。
読み方の例
性別列を選び、female を「精度を下げている要因」として選んだとします。混合行列で「0 と予測したが実際は 1 だった」が 36% を占めていたら、female の行で 1 を取りこぼしていると読めます。
年齢のような数値列なら、「16 〜 21」のような範囲について同じことを読みます。範囲「16 〜 21」で「0 と予測したが実際は 1 だった」が 34% なら、この年齢層で 1 と判断するための手がかりが足りていません。
次の一手
| 読み取れたこと | 打ち手 |
|---|---|
| 特定の値・範囲でだけ外している | その区分を説明できる列を説明変数に足す |
| その区分の行数がそもそも少ない | 行を増やすか、不均衡データに対するサンプリングで偏りをならす |
| 片方のカテゴリばかり取りこぼす | オートMLのオプションで、最大化する指標を 再現率[Recall] に変える |
機械が重視したデータとの違い
| 見るところ | 機械が重視したデータ | 精度改善の余地 |
|---|---|---|
| 何を説明しているか | 予測そのもの | 予測が当たったか外れたか |
| 使うデータ | 訓練に使ったデータ | 検証に使ったデータ |
| 調べ方 | 採用されたモデルをそのまま調べる | 当たり外れを当てる別のモデルを作って調べる |
| 答えてくれる問い | どの列で判断したか | どの列のせいで外れているか |
| 棒の色 | 緑 | 桃色 |
| 混合行列 | 無し | 範囲ごとに出る |
関連
モデル詳細情報 同じまとまりのほか
機械が重視したデータ 同じまとまりのほか
精度検証結果 全体の当たり具合
オートML モデルを作り直す
マニュアルML モデルを作り直す
モデルで予測値算出 別のデータに当てる
ボニートくんへのアクセス ボニートくんの開き方