
モデル詳細情報
探索の途中で作られたモデルを全部並べる画面です。 オートMLとマニュアルMLは、いくつものモデルを作って比べ、いちばん良かった 1 つだけを出力します。ここに出るのはその候補の一覧です。MLアンサンブル(βver)で混ぜるモデルは、ここの モデルID で指定します。
構築モデル一覧
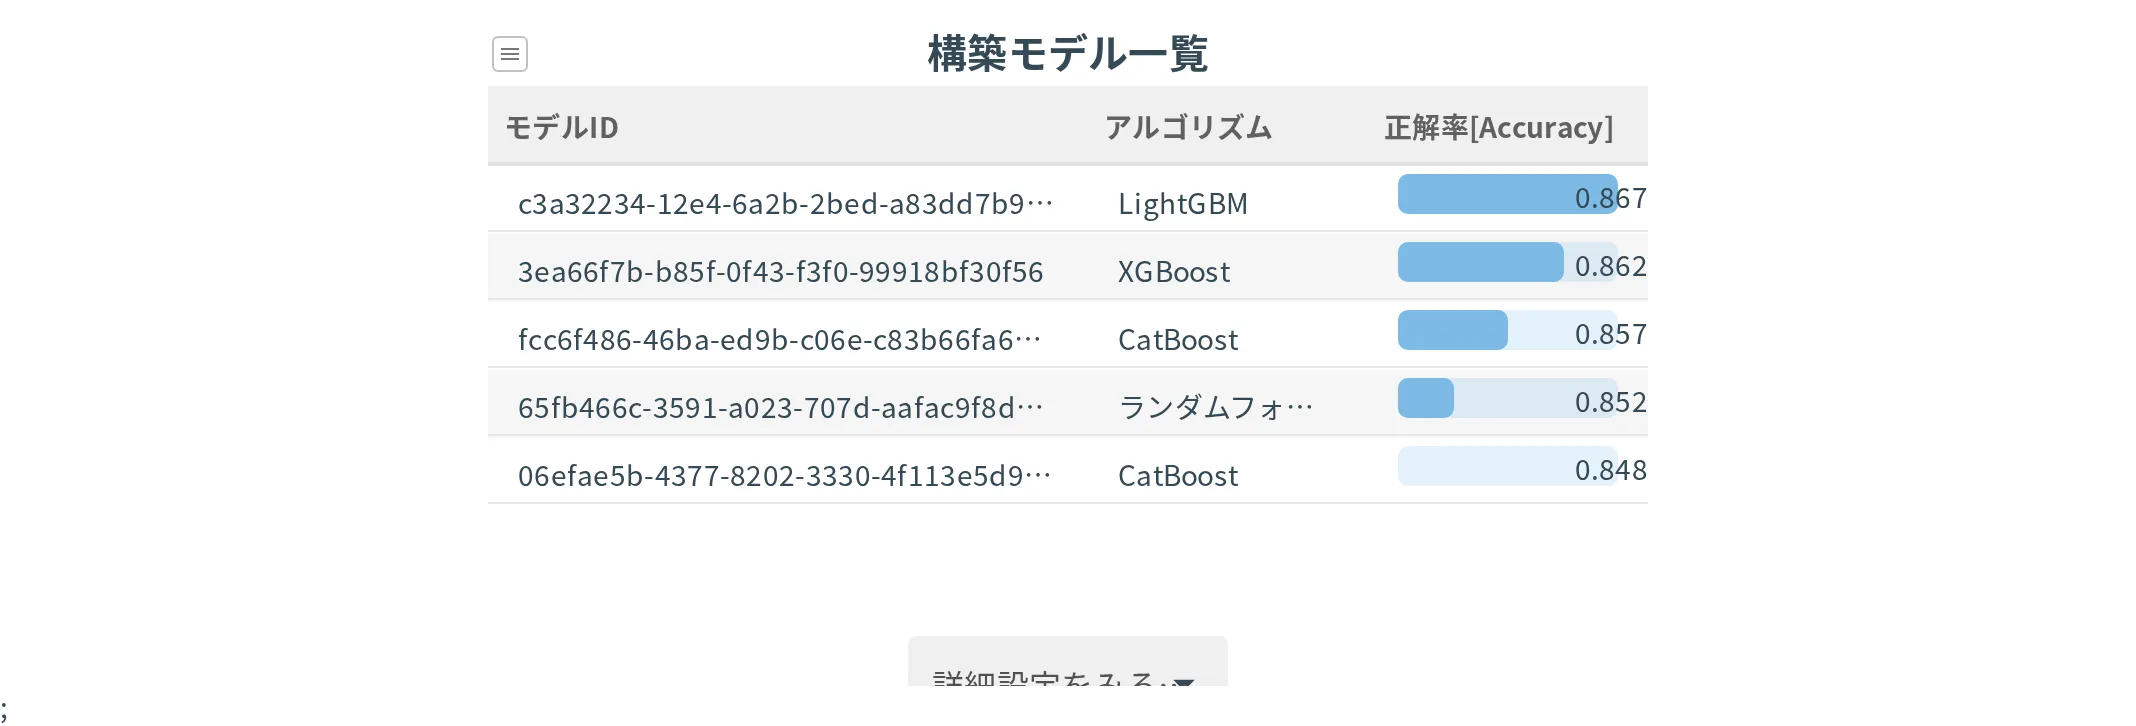
作られたモデルが、精度の良い順に上から並びます。
| 列 | 中身 |
|---|---|
| モデルID | そのモデルを指す文字列。MLアンサンブル(βver)に渡すのはこの値です |
| アルゴリズム | 使われた学習アルゴリズムの名前 |
| (指標名) | モデルを選ぶときに使った指標の値。横棒の長さでも分かります |
並び順は、カテゴリ予測なら指標の大きい順、数値予測なら誤差の小さい順です。どちらも上がいちばん良いモデルです。
詳細設定をみるモデルIDを選択
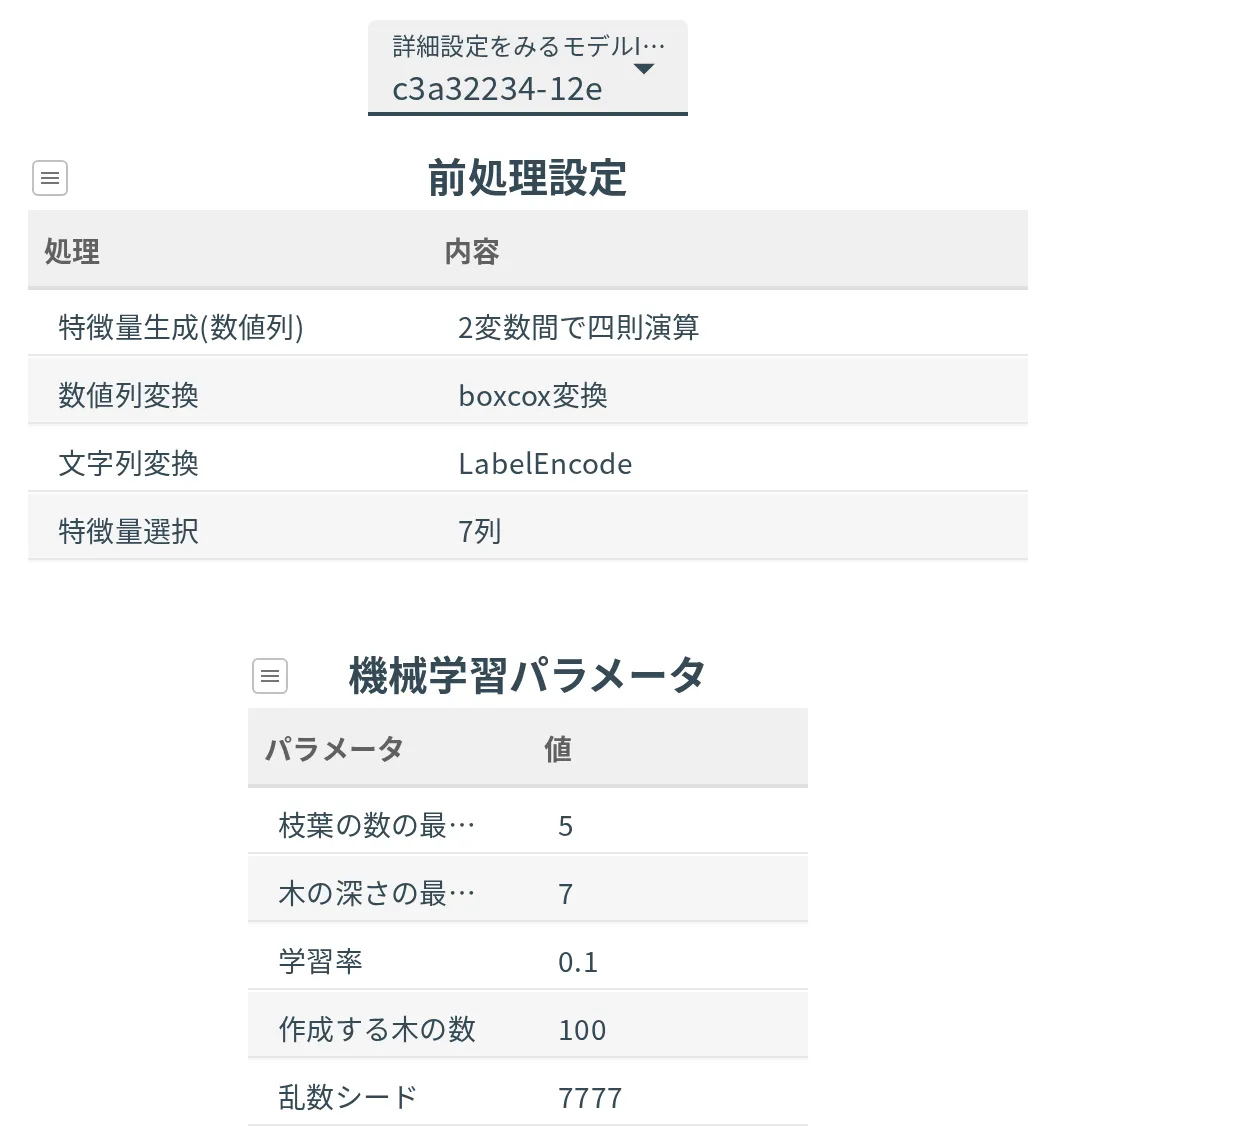
プルダウンでモデルIDを 1 つ選ぶと、そのモデルの中身が下に 2 つ出ます。
前処理設定
処理と内容の 2 列で、そのモデルに適用された前処理が並びます。最後の行に特徴量選択が出て、何列まで絞ったかが分かります。
機械学習パラメータ
パラメータと値の 2 列で、そのモデルのパラメータが並びます。
使いかた
| やりたいこと | 見るところ |
|---|---|
| 混ぜる候補を選ぶ | 上位数件のモデルIDを控えてMLアンサンブル(βver)のパターンに入れる |
| 1 位と 2 位の差を知る | 一覧の指標の値を見比べる。差が小さいなら、混ぜる価値があります |
| 採用されたモデルの設定をマニュアルMLに写す | 1 行目のモデルIDを選び、前処理設定と機械学習パラメータを読む |
関連
精度検証結果 同じまとまりのほか
機械が重視したデータ 同じまとまりのほか
精度改善の余地 同じまとまりのほか
MLアンサンブル(βver) モデルIDを使って混ぜる
学習プロセス 採用された 1 つの経緯を追う
モデルで予測値算出 別のデータに当てる
ボニートくんへのアクセス ボニートくんの開き方