
機械が重視したデータ
モデルがどの列を手がかりにしたかを並べる画面です。 中身の確認だけでなく、「何が結果を左右しているのか」を知る要因分析としても使えます。
影響度比較
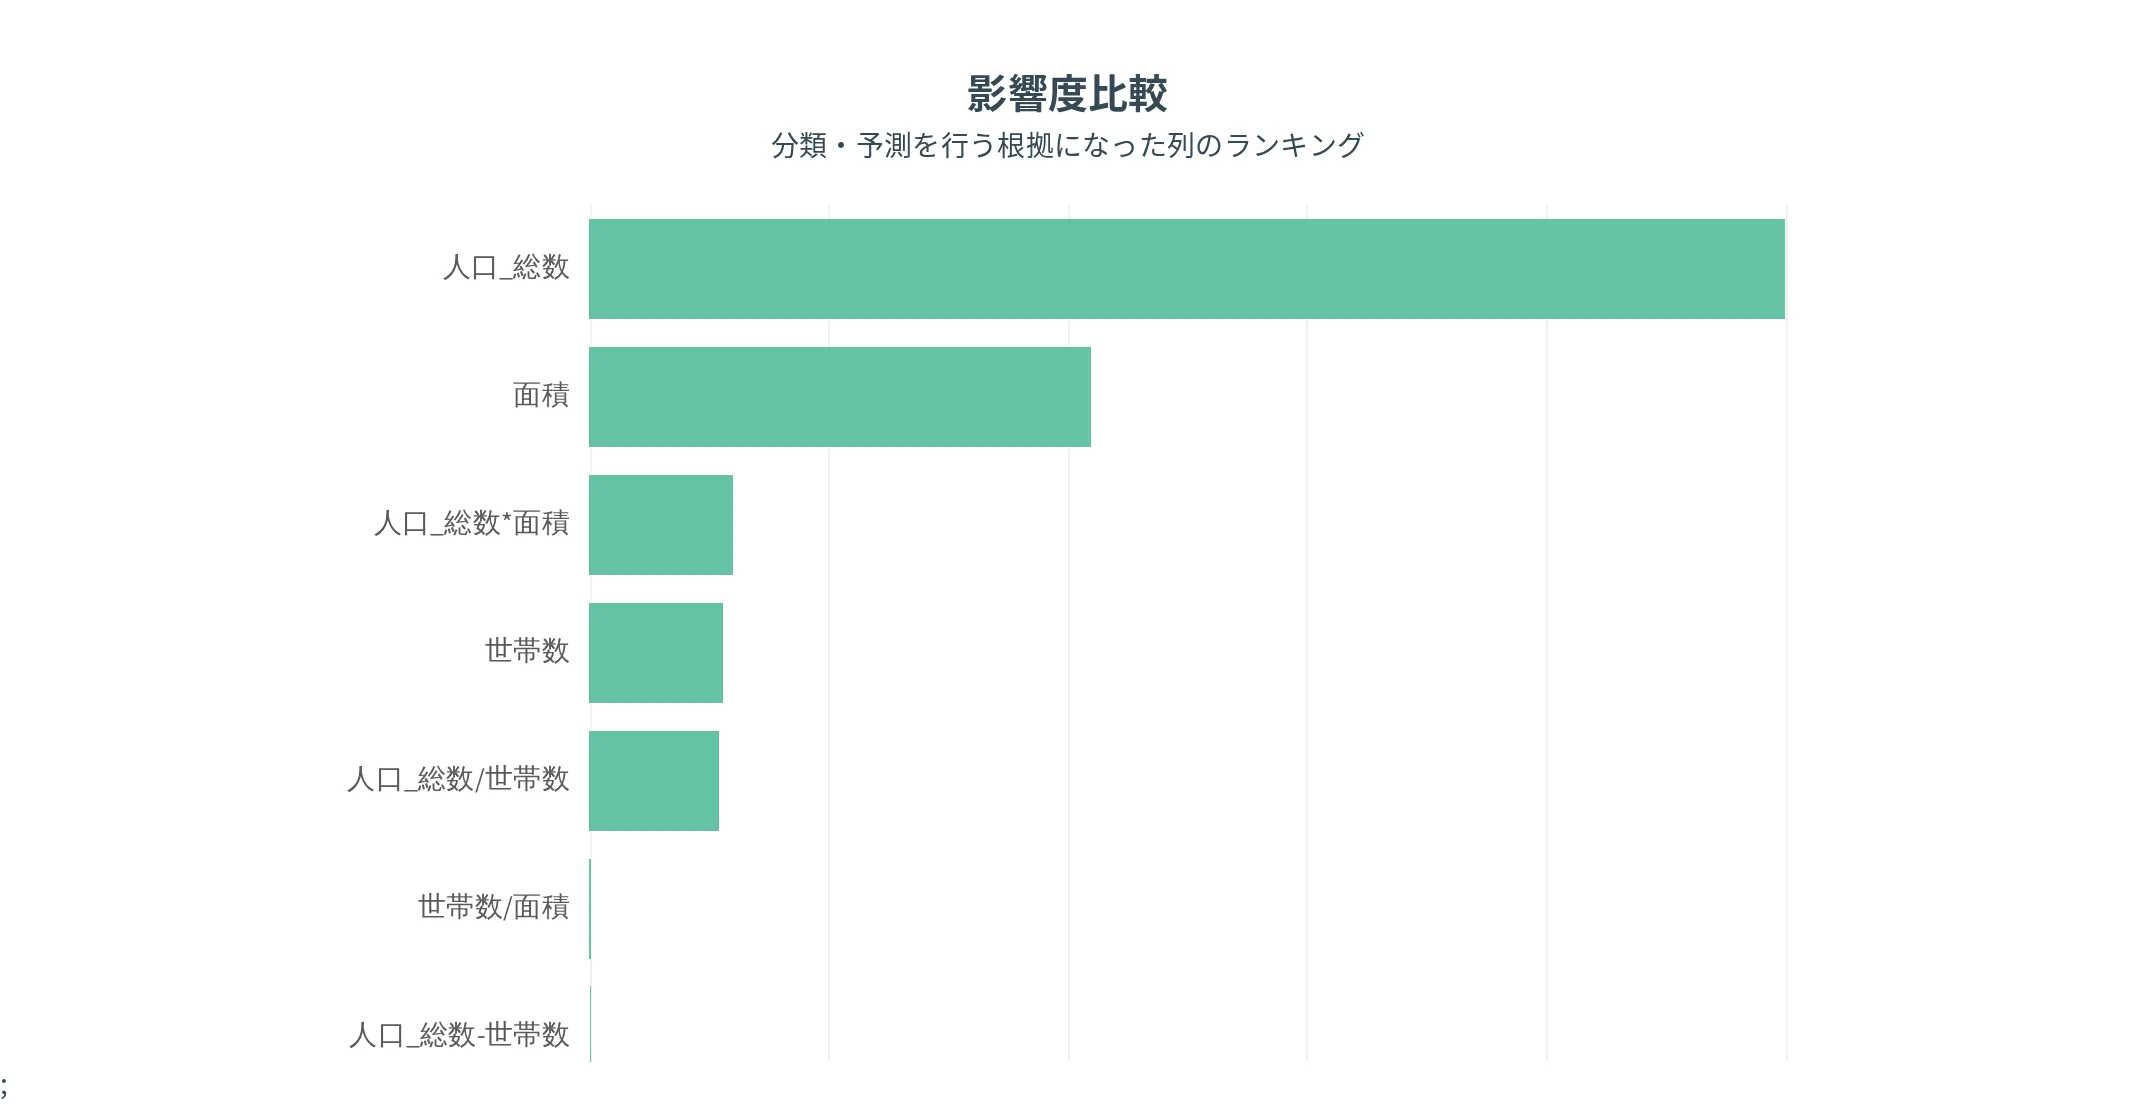
分類・予測を行う根拠になった列のランキングです。 上にある列ほど重視されています。
棒の長さはいちばん重視された列を 100 とした相対値です。単位はありません。列どうしの大小だけを見てください。
列ごとの範囲分解
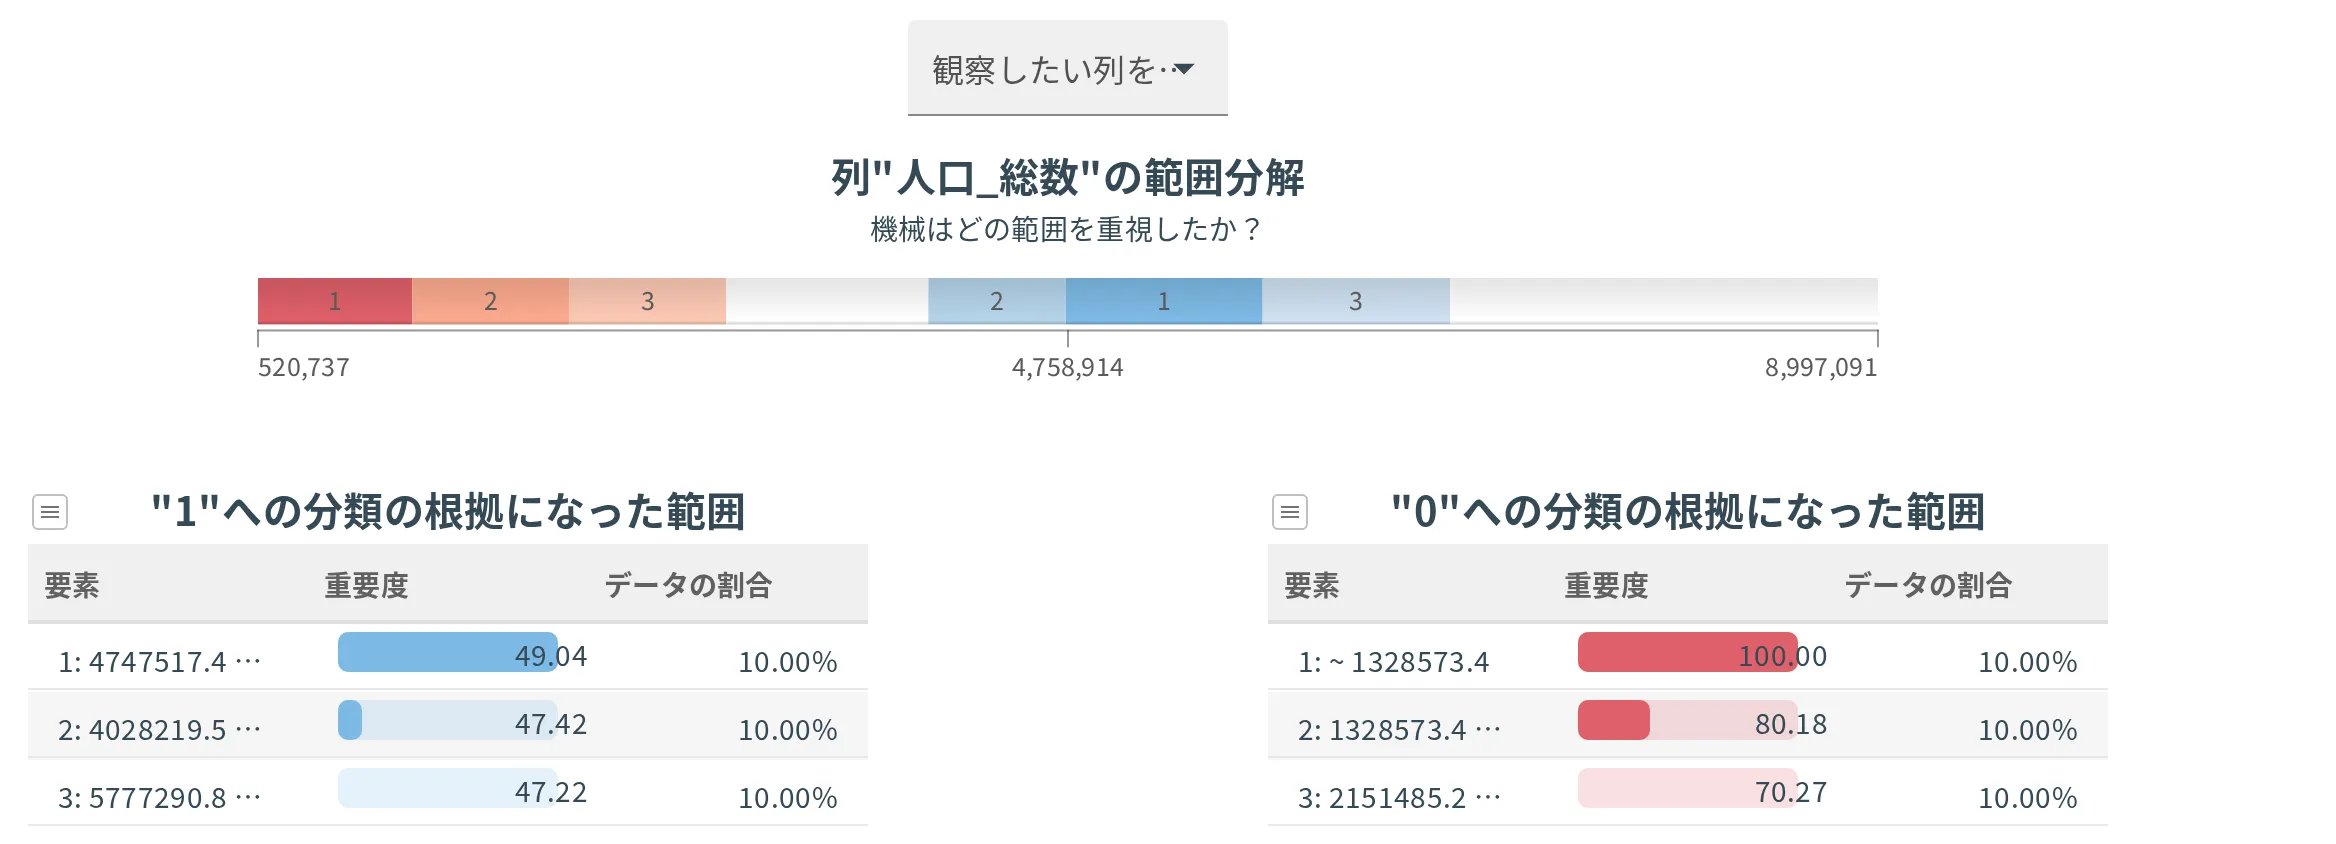
下のプルダウン「観察したい列を選択」で列を 1 つ選ぶと、その列の中のどの値・どの範囲が効いたかが出ます。 見出しは「列”(列名)“の範囲分解」になります。
| 選んだ列の型 | 分け方 |
|---|---|
| 文字列 | 値ごと |
| 数値 | 件数が同じになるように 10 の範囲に分けます。同じ値が多くて 10 に分けられないときは 5 の範囲 |
表には要素・重要度・データの割合が出ます。データの割合は、その値や範囲が全体の何 % を占めるかです。割合が小さい範囲の重要度は、少ない行から出た数字なので、鵜呑みにしないでください。
読み方(カテゴリ予測が 2 択のとき)
2 つの表の見出しに、どちらへ寄せたかが出ます。
| 見出し | 意味 |
|---|---|
| “(カテゴリ名)“への分類の根拠になった値 | その値が出ると、そのカテゴリに分類されやすい |
| “(カテゴリ名)“への分類の根拠になった範囲 | その範囲に入ると、そのカテゴリに分類されやすい |
たとえば性別列で、female が「“1”への分類の根拠になった値」に、male が「“0”への分類の根拠になった値」に並んでいれば、性別が female なら 1 に、male なら 0 に分類されやすいと読めます。
数値の列も同じで、年齢列なら「14 以下」のような範囲が並びます。
読み方(カテゴリが 3 つ以上のとき)
見出しが「分類の根拠になった値」「分類の根拠になった範囲」になり、どちらのカテゴリへ寄せたかは出ません。 押し下げ側の表も出ません。どのカテゴリへ効いたかまで知りたいときは、条件で行をフィルタで 2 択に絞ったデータで作り直してください。
読み方(数値予測のとき)
見出しが「目的変数の増加方向の予測の根拠になった範囲」「目的変数の減少方向の予測の根拠になった範囲」になります。目的変数を押し上げる側と押し下げる側、という読み方です。
精度改善の余地との違い
精度改善の余地は見た目がそっくりですが、測っているものが違います。
| 見るところ | 機械が重視したデータ | 精度改善の余地 |
|---|---|---|
| 何を説明しているか | 予測そのもの | 予測が当たったか外れたか |
| 使うデータ | 訓練に使ったデータ | 検証に使ったデータ |
| 調べ方 | 採用されたモデルをそのまま調べる | 当たり外れを当てる別のモデルを作って調べる |
| 答えてくれる問い | どの列で判断したか | どの列のせいで外れているか |
| 棒の色 | 緑 | 桃色 |
| 混合行列 | 無し | 範囲ごとに出る |